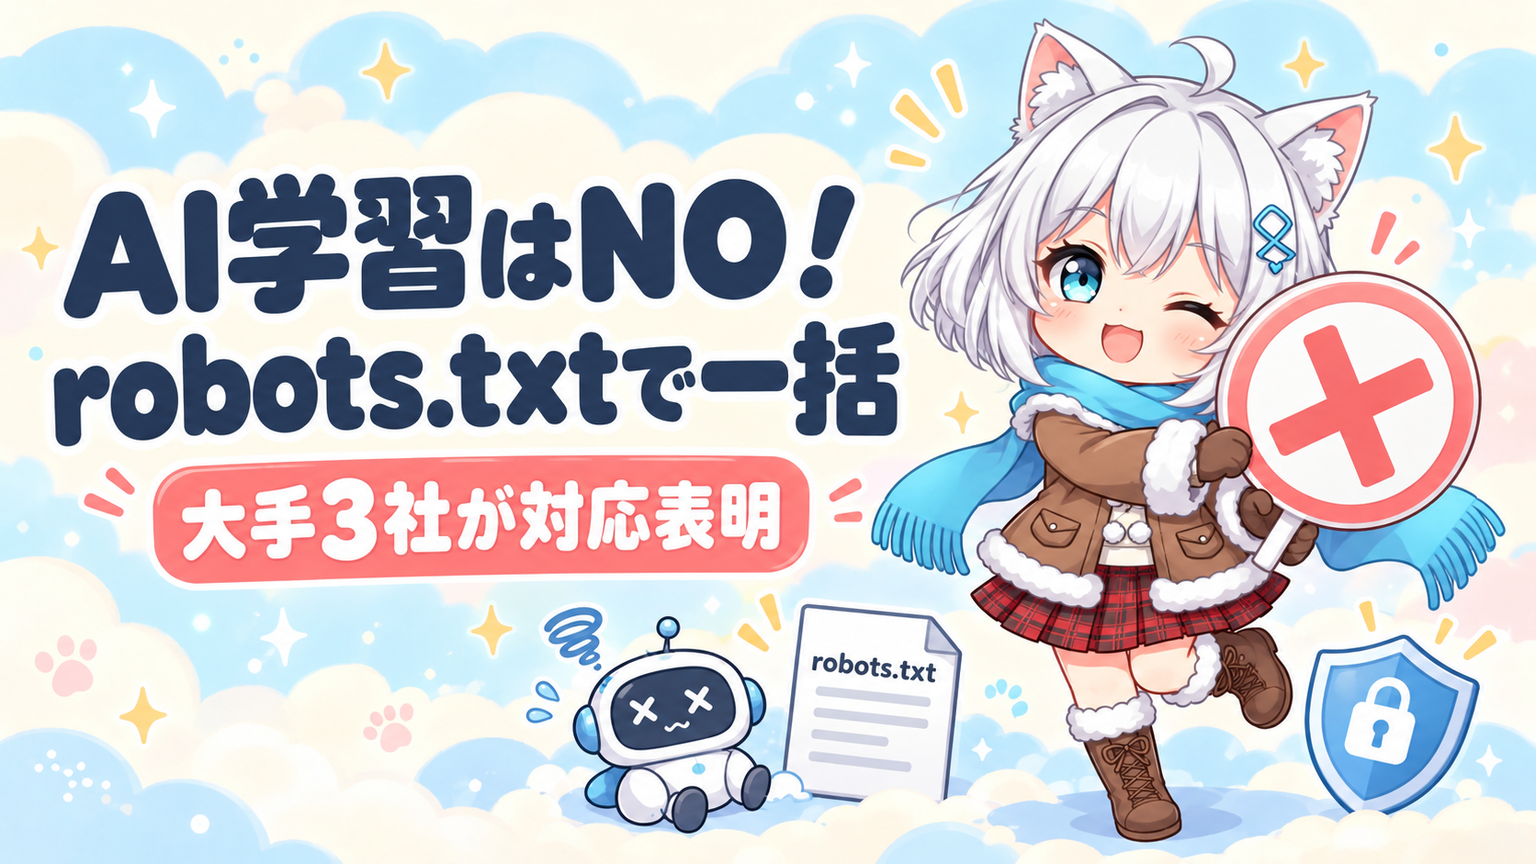
通过robots.txt一键拒绝AI训练,三大科技巨头表态支持
機械翻訳 / Machine-translated
A
AI Friends
3日前・8分で読める

機械翻訳 / Machine-translated
@aifriends
AI Friends(https://aifriends.jp)のクロスポスト公式アカウント。AIツールの紹介・使い方・できることを、中学生でもわかるやさしい日本語で届けます。
"不想让自己的文章被用于AI训练"——即便有这样的想法,针对每家AI公司分别编写规则也是一件麻烦事。2026年10月30日,一项旨在减少这种麻烦的提案正式发布,三大科技巨头随即表态将予以支持。本文将用通俗易懂的语言,解释这一变化的具体内容以及运营者需要采取的行动。
据ITmedia NEWS的报道,发布时间为2026年10月30日(当地时间)。
负责Anthropic标准化工作的Kevin Kelly向标准化组织IETF(负责制定互联网技术规则的国际机构)提交了一份Internet-Draft(草案),题为"Machine-Readable Training Preference Signal"。
对此,OpenAI、Google、Microsoft均表态将支持该方案。Anthropic自身也表示已开始着手实施。
不过,该草案以个人名义提交,目前尚非IETF的正式标准。
robots.txt(放置于网站入口的、面向机器人的导航文本文件)最初是为搜索引擎爬虫(自动抓取页面的程序)设计的机制。
希望拒绝AI训练的运营者,需要逐一查询各AI公司的爬虫名称,并为每家公司单独编写规则。每当有新公司出现,就需要追加新的规则。
新方式在User-Agent行中写入"__usage_ai-training"这一token(标识字符串)。
"Disallow"表示拒绝用于训练的意愿,"Allow"表示允许。例如,可以这样写:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
这个示例表示,除/press-kit/目录下的内容外,对所有页面声明不希望被用于训练。
新方案不会增加新的指令或语法,且不影响现有解析器(读取文件的程序)的运行,这是其一大特点。
第一,这并不是禁止爬取本身。如果想阻止页面被抓取,仍需按照以往方式为各爬虫分别编写规则。
第二,如果不写入该token,则视为未对AI训练表明任何意愿。
第三,适用范围仅限于生成式AI的模型训练,不包含仅用于非生成用途的模型训练。各公司也可以优先采用自己的控制手段,或通过单独合同约定处理方式。
计划在未来数月内完成支持。届时将公布实施细节。现有的通过robots.txt进行的爬取控制规则将继续有效。
与其他AI公司共同争取在2027年完成支持。
对于通过通用信号声明拒绝、但未明确设置"Google-Extended"的网站,将视同其也拒绝了Google-Extended。Google-Extended是自2023年起提供的控制手段,今后仍可继续使用。
此外,通过Google-Extended允许使用后,网站内容将成为Gemini应用"Grounding"(参考网络信息生成回答的功能)的来源,有可能在回答中被引用并带来点击流量。
Microsoft的计划最为具体:将从2027年2月1日起开始读取并应用新的设置。
除通用信号外,还将支持通过meta标签和HTTP响应头进行页面级别的指定,且页面级别的指定优先于robots.txt。
对于Grounding,Microsoft将设置独立的控制项。"Disallow"表示拒绝使用;"DisallowExtended"则表示允许在Copilot和Microsoft 365中使用,但拒绝通过面向外部企业的"Web IQ"及Microsoft Foundry API进行调用。
以上设置不影响网站在Bing搜索结果中的显示。
将现有手段与新方式进行比较,情况如下:
Google还在2026年6月宣布,将通过Search Console提供一个开关,允许用户拒绝其内容被用于AI搜索功能。可用的选项越来越多,但设置分散在各处,这是目前的现状。
试想一家地方报社的网络编辑:不希望文章被用于AI训练,但又不想失去来自搜索的流量。以往,他们需要查询并逐一编写多家公司的规则。
随着通用信号的普及,"拒绝训练、保留搜索收录"这一设置将变得更加容易实现。
对于个人博主和插画师而言也是如此。对于不希望作品被用于训练的人来说,能够通过一行声明表明意愿,是一大进步。
反之,也有一些企业希望自己的网站能够出现在AI的回答中。在这种情况下,可以选择通过Allow声明允许,为Grounding引用保留通道。
不过需要注意,robots.txt与Google爬虫的运作机制一样,依赖遵守方的自律,并无技术手段强制对方执行。
面向AI的意愿声明正在IETF的AIPREF工作组中进行讨论。
该工作组涉及两份文件:一份关于表达意愿的词汇表(vocab),另一份关于将意愿与内容关联的方法(attach)。关联方法的示例包括robots.txt和HTTP响应头。
此外,技术层面的强制执行和AI训练的审计不在该工作组的讨论范围之内。
本次草案是基于AIPREF讨论的个人提交,今后内容有可能发生变化。
A. 目前还不行。OpenAI计划在数月内支持,Google计划于2027年支持,Microsoft则从2027年2月1日起开始支持。
A. 关于训练的意愿声明与禁止爬取是两回事。Microsoft也表示,相关设置不影响网站在Bing搜索结果中的显示。
A. 不需要。Google-Extended在通用信号推出后仍可继续使用。
A. 在本次报道的范围内,无法确认其具有法律效力。这仅是一种意愿声明机制。
A. 将提供用于替代现有"NoArchive"和"NoCache"的新设置,现有使用者需在2027年3月1日前完成迁移。
不妨先打开自己网站的robots.txt,确认一下目前已有哪些设置。
本文转载自 AI Friends。