我的文章只得了22分——用yomiyasu修正AI味日语
機械翻訳 / Machine-translated
伊東雄歩
5時間前・9分で読める
GitHub上有一个Agent Skill,发布两天内就获得了超过1,000个Star。它叫yomiyasu(よみやす),专门用于将AI写的日语改写得更易读。我用它附带的评分脚本对自己已发布的28篇文章进行了测试,最低分只有22分。
这是大贺爱一郎(@oga_aiichiro)个人开发的Agent Skill,用于推敲AI生成的日语文章,采用MIT许可证。适用对象是技术文章、设计文档、PR说明等实务性文字。支持Codex、Claude Code和Cursor,安装只需一行命令。
将草稿交给它,说"把这段文章改得易读一些"即可。用途分为tech、business、essay三种,省略则自动判断。
发布日期为9月30日。截至10月2日,已更新至v1.0.2。README最后写道:"本README使用『yomiyasu』撰写。"
首先容易想到的方式是提供一份"禁止使用这些词"的清单。大贺在Zenn的解说文章中写到了这种方式的局限性。
禁止某个词,AI只会换一个词来表达。
| 禁用词 | AI的替换词 |
|---|---|
| 手触り(手感) | 実態(实质) |
| 地味に効く(悄悄起效) | 効果を発揮する(发挥效果) |
| 〜側に倒す(偏向〜一侧) | 〜の方針に寄せる(靠近〜方针) |
文章的骨架并没有改变。若要求"写得更有人情味",AI反而会堆砌真理、境地、美学之类夸张的词汇。
大贺调查了现有5个AI味对策Skill的正文,发现本应属于禁用对象的"効く(起效)"一词共出现了28次。LLM会将提示词的文体作为范本——如果指令文本充斥比喻,输出中同样会渗透出来。
大贺最初编写的正则表达式按字面匹配了"握る(握)"、"倒す(推倒)"、"壊れる(损坏)",结果连"コンビニでお握りを買って食べました(在便利店买了饭团吃)"和"お腹を壊してしまいました(肚子坏了)"也被检测出来。在由日常用语和惯用语构成的48个边界测试中,有46个(占95.8%)出现了误检。加入前后文条件后,误检降为0件。
那么,这类词汇在AI普及之后增加了多少?逆瀬川ちゃん从发布于Qiita的70,524篇文章中选取50,731篇进行了分析。文章开头写明了统计的理由:
不过,仅凭直觉来谈这类问题往往会出偏差,所以我收集了2019年至2026年各年8月发布在Qiita上的全部文章,实际统计了一番。
| 指标 | AI普及前(2019〜2022年) | 2026年 |
|---|---|---|
| 加粗(每1,000字) | 1.26个 | 3.83个(约3倍) |
| 项目符号占比 | 8.9% | 16.4%(约1.8倍) |
| 含"効く"的文章 | 2.0% | 22.3% |
| 含"壊れる"的文章 | 0.8% | 13.1% |
| 含"静か"的文章 | 0.1% | 4.9% |
附有说明:"AI写的文章增多"与"人类写作方式的改变"无法加以区分。表中数字反映的是Qiita投稿文章整体的变化。
另一方面,曾被视为AI腔代表的"しましょう(让我们……吧)"却在减少。仅追踪特定词汇,无法捕捉正在发生的全貌。
Kiminori Yokoi(@nasuvitz)的幻灯片《AI臭い文章とは何なのか(所谓AI味文章究竟是什么)》截至10月2日已有超过7万次浏览。他对AI味文章的定义如下:
"从不必要的对比、否定、保留开始,不直接写出主旨的文章";"大量使用抽象词或比喻性动词,导致具体行为模糊不清的文章"。
令人不适的原因在于:本应由不同人写出的文章,却一再出现相同的习惯。"感觉所有人都在用同一个幕后捉刀人。"
yomiyasu的README表示,这份幻灯片是制定原则的参考依据。7条转换原则的核心是:每句话都写回"谁·做什么·怎么做";将比喻性动词还原为实际操作;不添加原文中没有的信息。
引用幻灯片中的修改示例:
"判断に迷うものは、残さない側に倒します。(拿不准的就偏向不保留那一侧。)"
→"採否を判断できない項目は、原則として除外します。(无法判断取舍的项目,原则上予以排除。)"
文章变得清晰可见——谁在做什么。
在发布次日的v1.0.1中,修正了改写后导致含义改变的问题。
原文"単にメッセージを流すだけでは、背後でデータが静かに壊れます。(仅仅发送消息,数据就会在背后悄然损坏。)"
修正后"単にメッセージを送るだけでは、気づかないうちに裏でデータの整合性が失われます。(仅仅发送消息,数据一致性就会在不知不觉间于背后丧失。)"
被列为错误改法的,是擅自改成"〜おそれがあります(可能……)"从而弱化语气的模式。如果原文是断言,就以断言的方式修改。像"骨が折れる(费劲)"这类早已固化的惯用语则不予改写。判断标准是"在AI普及之前的人类文章中,这种表达是否也属常见"。
v1.0.2中,还禁止了推敲过程中擅自添加"〜が大切です(……很重要)"、"〜する必要があります(需要……)"的问题。输出结构调整为4部分:"改写后的正文"、"修改的地方"、"保留的AI味表达"以及"需要向作者确认的事项"。
我用附带的yomiyasu_lint.py对miraipage上已发布的28篇文章进行了测试。该脚本采用100分制扣分制,检查加粗频率、项目符号比例、比喻动词等内容,仅需Python标准库即可运行。
中位数为84分。满分100分的只有2篇,均为700字以下的短文。最低分22分,其次是43分。
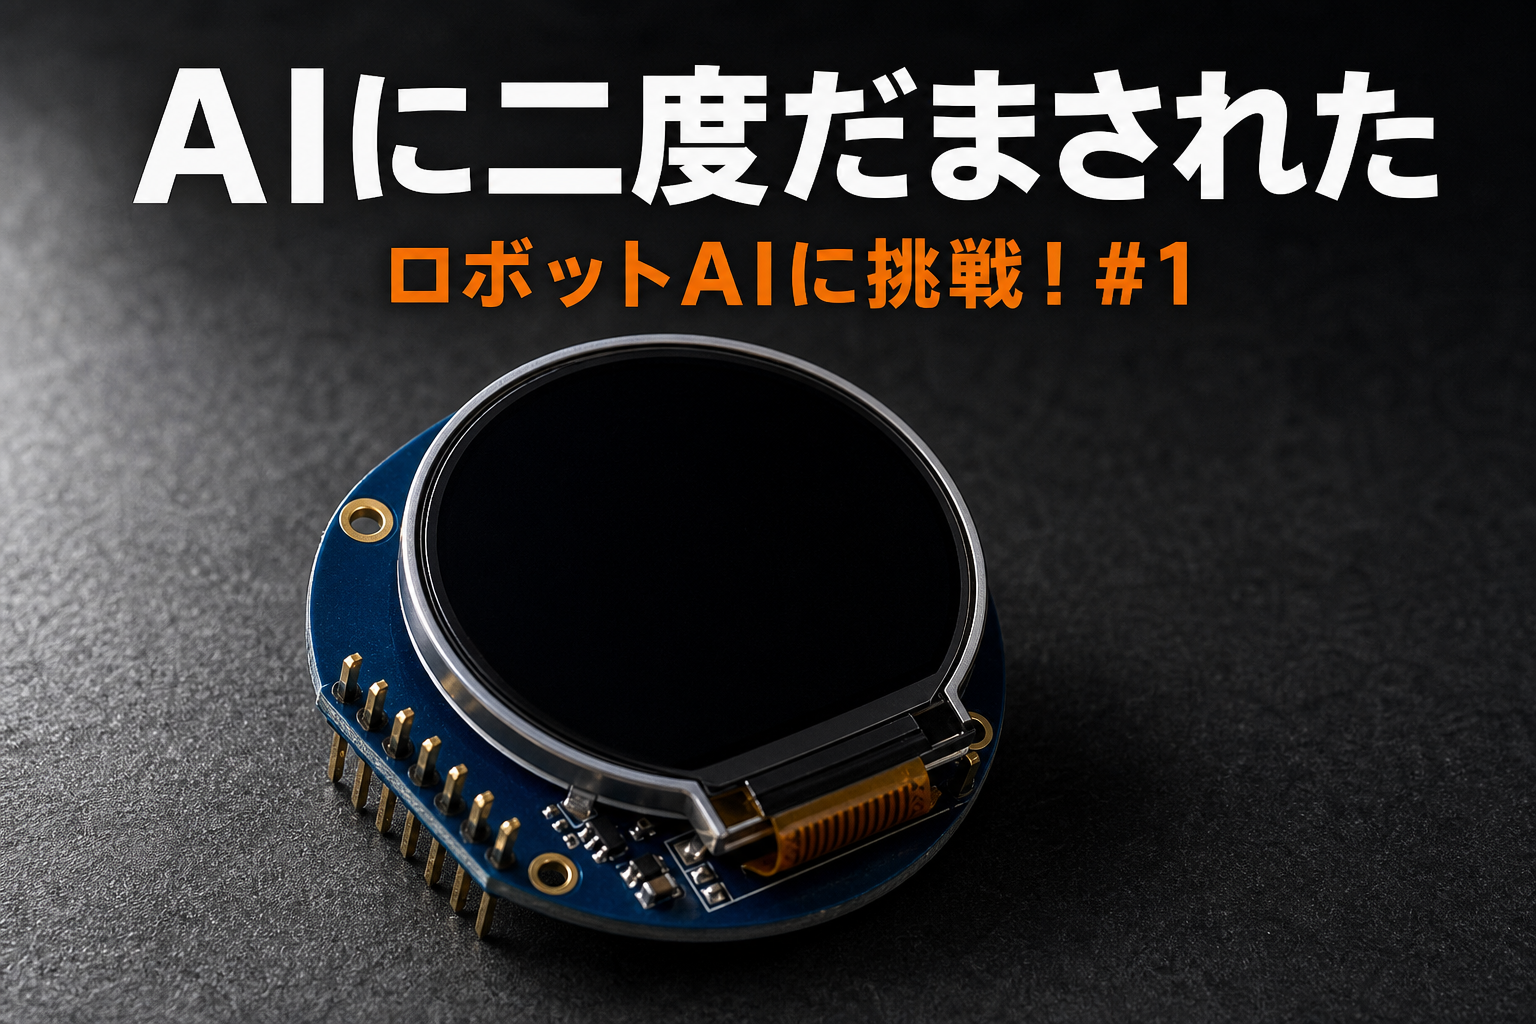
22分的文章是9月15日发布的《ロボットペットを作る。部品が決まるまでに、AIに二度だまされた》(约4,800字),共有18条指摘。最多的是英文单词前后的半角空格,共10条;其他还有AではなくB(不是A而是B)句式4条、土台(基础)3条、加粗频率超标1条。
半角空格是大贺在解说文章中列出的修正对象之一,指的是日语与英文单词之间机械性插入的空白。加粗共25处,每1,000字5.21个,多于逆瀬川ちゃん调查中2026年Qiita的3.83个。
土台的3处,是我在文章中以字面意义(机器人底座)使用的。脚本也会提示"如果承担的是字面含义或必要的语境,可以保留"。是否采纳由作者自行决定。
也有脚本未能捕捉到的地方。同一篇文章中,我写了"4つ目が一番効くと思っている(我认为第四点最有效)"和"組込みで時間が溶けるのは(时间在嵌入式开发中悄然流逝)"。"効く"正是逆瀬川ちゃん调查中确认急剧增加的那个词。
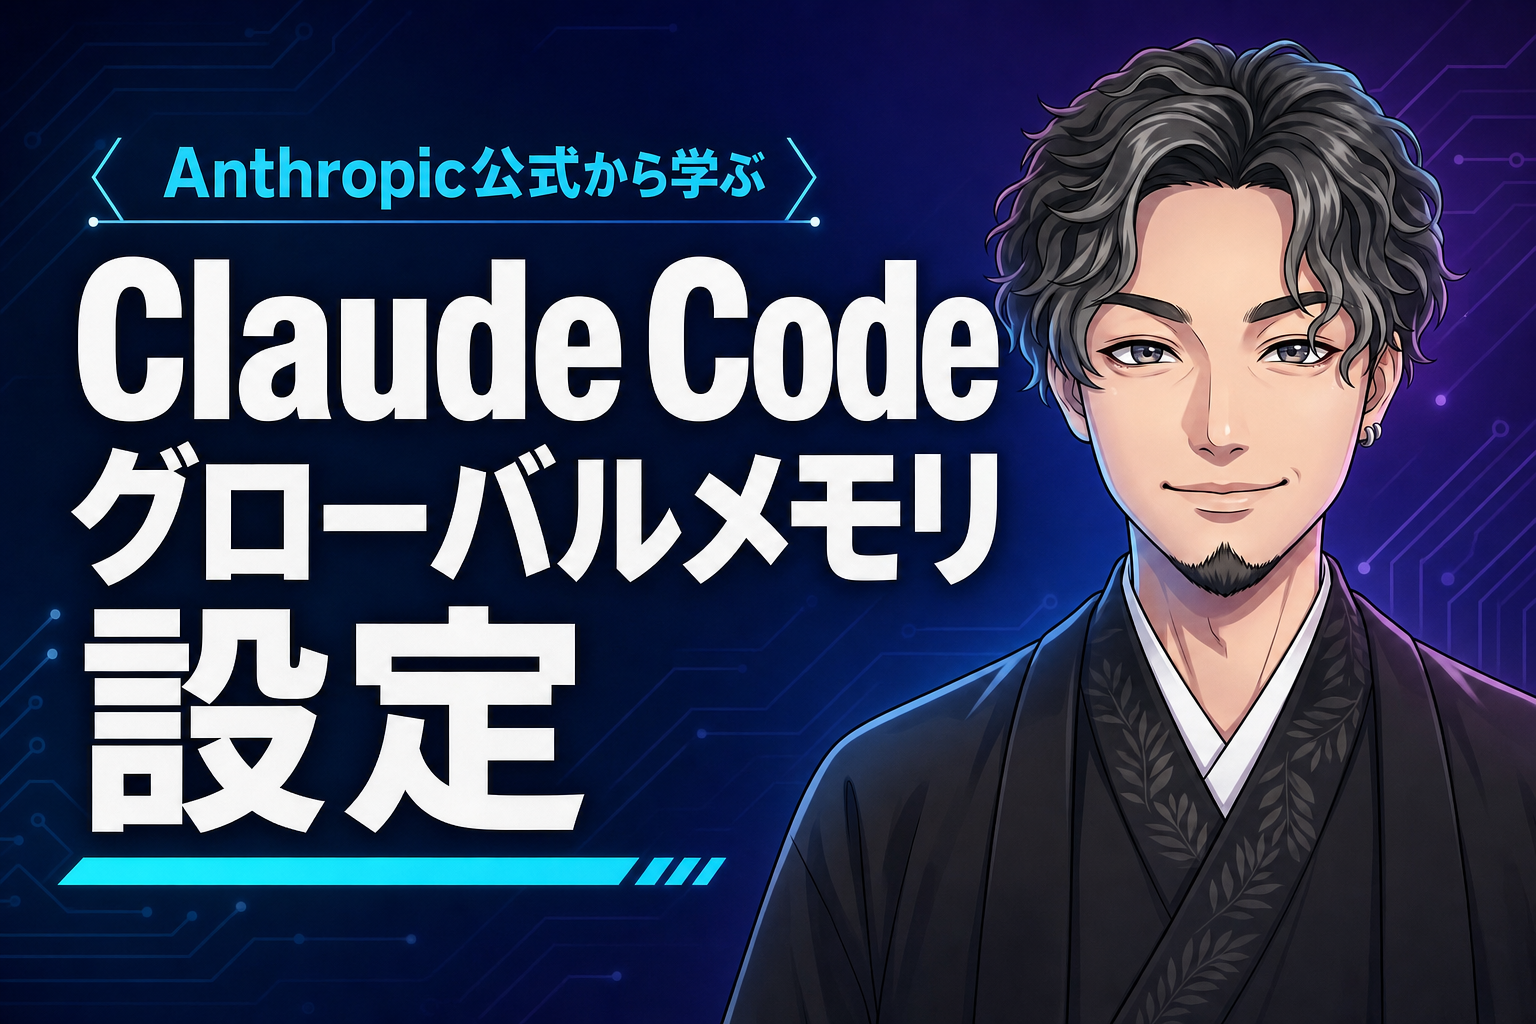
同日(9月15日)发布的《Anthropic公式から学ぶ、Claude Codeのグローバルメモリ設定》得了89分。这篇文章写的是我在Claude Code的通用设置中添加了"能直说的,不用比喻替换"这条规则的经历。
也就是说,在我添加这条规则的同一天,另一篇文章里却写下了"一番効く(最有效)"。制定规则,与测量写出的文章,是两件不同的事。
laiso在《为什么想消除AI味?》中将消除AI味的动机分为两类:"真正确认内容并承担自己责任",以及"看起来像是确认过、以便不被追责"。他写道,只消除词汇和符号的工具更接近后者。
关于令人不适的根源,他这样写道:"让人恼火的,是认认真真花时间读完,结果内容空洞的时候。"
南健太郎(ktrmnm)也写到了同样的问题。即使脱臭成功,发布文章的人是否真正理解内容、能否承担责任,是另一回事。持续用固定规则脱臭也很困难,因为不同模型有不同的习惯,而且每隔几周到几个月就会更新。
南将AI slop和workslop这类词汇,总结为"说白了就是:别浪费我们的时间"。
yomiyasu本身在v1.0.2中也在输出中加入了"需要向作者确认的事项"。确认的工作由人来完成,这是即使改了文体依然留存的任务。
使用Claude Code只需一行:
npx skills add nanaism/yomiyasu
更新用npx skills update yomiyasu。也可作为插件安装。评分脚本用python3 scripts/yomiyasu_lint.py article.md运行。加上--strict参数后,出现警告时返回退出码1,可集成到CI中。
若同时启用多个修正AI文体的Skill,指令会产生冲突。建议只选一个使用。
本文也是由Claude起草,经yomiyasu评分脚本检查后发布的。初始得分53分。10条指摘全部来自将检测目标词作为示例引用的段落。脚本不检查表格、引用块和代码格式内部的内容。将示例移入这些格式后,得分变为100分。